Sistema operativo
Distribuzioni
Poiché si assume che del software proprietario è impossibile andare a verificarne al 100% la sicurezza, si assume di escludere a priori tutte le soluzioni non libere o controverse: Ubuntu per esempio ha stretto in passato accordi con Amazon, per non parlare del fatto che apt di default va ad usare Snap senza il consenso dell'utente (Snap ha il server API che fornisce metadati, proprietario e sudo passa i privilegi di root da apt a snap, poiché in apt è stato messo di default il package manager snap. E questa è una posizione presa da Canonical verso Ubuntu e anche da altre community come PopOS), oppure del fatto che gli utenti anziché avere permessi (umask) 0022 hanno 0077, Redhat utilizza dei repository a pagamento (su CentOS si usavano infatti gli EPEL) e sottosta a delle policy aziendali, il che significa che potrebbero esportare verso l'esterno delle statistiche, stessa cosa OpenSuse. Debian ha una filosofia di sviluppo che non va a risolvere diversi bug che potrebbero essere implementati fin da subito e non supporta molto software. Slackware, Void Linux, Alpine Linux e Gentoo per loro natura potrebbero essere delle buone soluzioni (compreso ovviamente LFS). Per un uso Desktop è consigliabile magari un sistema operativo come Artix Linux (è instabile, evitare di usarlo a livello server) o Gentoo per lo sviluppo e Whonix per l'anonimato.
Stable vs rolling release
A livello di sicurezza, per un uso server e non desktop è sicuramente meglio una versione stable, al fine di non incombere in disservizi. Le versioni rolling release sono più indirizzate verso coloro che vogliono testare le ultime novità per quanto riguarda il software, pertanto è una questione più relativa all'ambito dello sviluppo e del testing che nell'utilizzo lato server. Il che rende distribuzioni come Alpine Linux non adatta per un uso server, seppur si debba riconoscere che non usa systemd e al posto di glibc usi musl.
Documentazione e community
L'unico sistema operativo che garantisce un'ottima documentazione ed un tracciamento dei pacchetti con le
relative CVE, è tutto il ramo relativo a BSD: per Tutanum, in particolare, sarebbe meglio implementare
OpenBSD anziché
FreeBSD in quanto ha una filosofia più stable e in quanto è noto per essere usato in casi di massima
sicurezza. Vorrei citare anche le documentazioni di Arch Linux e di Gentoo che sono sicuramente degne di
nota, ma presentano purtroppo delle problematiche che indagheremo poi nei punti successivi.
Inoltre FreeBSD ha una licenza che gli consente più applicazioni commerciali rispetto ad OpenBSD, il che la
rende soggetta a influenze di stampo economico.
Preferire dunque OpenBSD o FreeBSD?
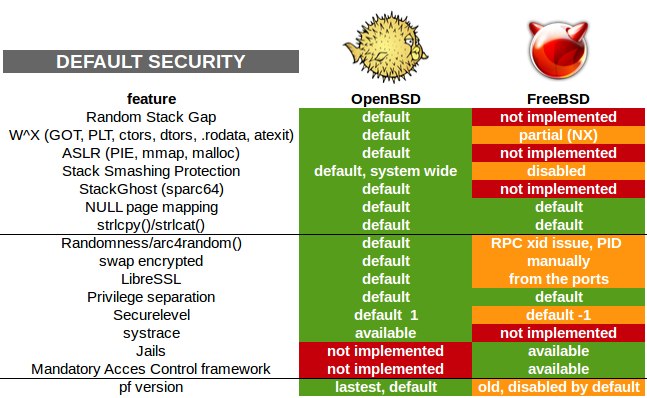
Come si può leggere nell'immagine OpenBSD è molto più orientato alla sicurezza rispetto a FreeBSD, ma rimane comunque scoperto sul supporto nativo alle jail, che comunque rimangono ottime per l'isolamento dei processi e dunque per l'integrità del sistema in caso di attacco ad un qualche componente software, soprattutto applicativo, solitamente il più vulnerabile.
Filesystem
Per Tutanum è consigliato l'utilizzo di OpenZFS,
erede di ZFS, sviluppato originariamente da Sun
Microsystem, acquistata ed integrata da Oracle, la stessa azienda sviluppatrice del linguaggio di
programmazione Java. Nonostante ciò viene ostacolato ancora oggi dalle multinazionali.
OpenZFS viene scelto come filesystem predefinito nei sistemi BSD come FreeBSD e OpenBSD per via della sua
robustezza e gestibilità.
Dispone di una licenza aperta chiamata CDDL (Common
Development and Distribution License) ma nonostante ciò non è compatibile con la licenza del kernel Linux
(GPLv2).
Tra le funzionalità più importanti mancanti su filesystem come ext4 (ma non BTRFS) ci sono quella della
deduplicazione dei dati e quella degli snapshot.
I dati possono infatti essere recuperati tramite snapshot senza dovere ricorrere a ricostruirli tramite
strumenti di analisi forense come photorec con il relativo comando testdisk.
È buona prassi fare degli snapshot mensili dei dataset del filesystem in modo che in caso di compromissione
non vadano persi per sempre (se non recuperati appunto tramite photorec).
Gli snapshot sono solitamente in sola lettura, mentre su lvm2 (il software che gestisce i logical volume, i
volumi logici, ed è sviluppato da Red Hat, nonché IBM) lo hanno
cambiato da sola lettura a scrittura e lettura, cosa che da una parte farebbe preferire altre soluzioni
tecnologiche e dall'altra parte, per gli utenti meno incentrati su questioni strettamente tecniche,
presenterebbe un problema enorme di sicurezza: in caso di malware andrebbero a sovrascriverli
infettandoli.
Implementa inoltre nativamente la
cifratura GELI
(GELI encryption), cosa che gli altri tipi di filesystem non implementano. Filesystem come ext4 supportano
ufficialmente solo luks1 ma non luks2, ma di questo ne parleremo meglio nella sezione relativa ai boot
loader. Da tenere presente però che GELI è incapsulabile dentro a luks2.
La cifratura GELI su OpenZFS lascia scoperto solo il nome dei metadati del dataset, ma è possibile
nasconderlo ad eventuali "spioni" impostando nomi generici
(di solito i dataset sono due o di più); perguida
esempio, invece di mettere root o zroot si può impostare un nome generico come data00, per la home data01 e
così via, in modo che se un bot, uno spyware, un malware o comunque una "spia" andasse a leggerlo non
ricaverebbe il nome effettivo ma quello fasullo.
L'unico problema reale di OpenZFS è il problema della write amplification, ma è possibile configurarlo
per applicazioni specifiche come sql, minimizzando di fatto il
problema stesso.
Oltre all'utilizzo di OpenZFS (utilizzare ext4 solo in caso di incompatibilità), il secondo consiglio
riguardante il filesystem, per Tutanum, riguarda il tipo di partizionamento: deve essere rigorosamente di
tipo GPT (almeno per la partizione di boot), essendo che in tal modo non potrebbe dialogare con UEFI; ci
potrebbero essere infatti vulnerabilità o ci potrebbero essere malware
che sono solitamente sviluppate proprio per UEFI.
Snapshot
La snapshot di un filesystem è un'istantanea che viene fatta sui dati per tenere traccia della loro
situazione e sistemazione in un determinato momento. Non riguarda pertanto l'esatta replica dei dati ma una
rapida immagine di come essi appaiono in un determinato momento.
Si possono effettuare sia su BTRFS sia su OpenZFS. Per una piccola guida su come effettuare gli snapshot, è
possibile consultare questa pagina.
Boot loader
Il boot loader è il software che si occupa di caricare dalla memoria di massa in RAM il kernel del sistema
operativo, così che venga avviato in seguito l'init system e poi tutti gli altri processi.
Il boot manager invece è quella parte di software che permette di elencare i kernel disponibili, così da
potere lasciare all'utente la scelta relativa a quale caricare in RAM.
Ciò che invece permette la decifrazione dei dischi è un piccolo filesystem temporaneo chiamato initrd o
initramfs.
Il più famoso boot loader e boot manager è grub2 (detto anche GNU Grub), il quale supporta ufficialmente
solo la crittografia luks1, ad oggi considerato in realtà troppo vulnerabile per gli standard
crittografici.
La versione luks2, non è supportata ufficialmente da grub, è già capitato inoltre che cancellassero gli
header con dei malware. Dal 2018 hanno aperto ancora questo bug dove
se ne richiede il supporto ufficiale. L'unico ad avere fornito una mezza soluzione è stato Patrick
Steinhardt nel 2019 con questa patch, dove
argomenta come supporta solo la funzione derivata della chiave pbkdf2, questo perché attualmente manca il
supporto ad argon2id o argon2id da parte della libreria libgcrypt. Dice inoltre
che non sarebbe stato un
grosso problema raggruppare quegli algoritmi con grub stesso, ma che è stato deciso di non farlo per
mantenere basso il numero di patch richieste per il supporto iniziale di luks2. Specifica inoltre che
l'aggiunta in futuro sarebbe banale dal momento che la struttura del codice è già pubblicata, cosa che fa
intuire come a livello progettuale non vogliano proprio integrare tale supporto, per motivi che alla
community rimangono in realtà ancora celati o deviati su argomentazioni che travisano totalmente tale
mancanza di supporto.
L'implementazione custom di argon2 risulta ad oggi
possibile, ma non essendo completa
rimane comunque abbastanza limitata e piena
di problemi, soprattutto relativi
all'integrità della memoria.
Un altro esempio è quello che potrebbe riguardare un caso comune a tutti: se si hanno a disposizione due
dispositivi cifrati, come ad esempio la root e la swap, si deve usare la stessa passphrase, da inserire
tante volte quante sono le partizioni cifrate, in questo caso due.
Su grub inoltre se si sbaglia passphrase viene richiesto un riavvio della macchina, in quanto si ha a
disposizione un solo tentativo.
A parte la crittografia, grub risulta ad oggi essere oltretutto pieno di bug, e da internet si ricevono
potenziali attacchi informatici di cui non se ne conosce né la provenienza, né la tipologia di exploit che
sfruttano per rimuovere le chiavi luks (probabilmente sono problemi derivati da una privilege escalation
ottenuta da software buggati), cosa che svalorizza la sua
integrazione rispetto al progetto Tutanum.
Come soluzione a questo problema è possibile, per le distro GNU Linux, mitigare al problema svolgendo questi
punti:
- Utilizzare un utente che non abbia accesso ai gruppi se non a root, e che non abbia accesso a software buggati che potrebbero presentarsi sottoforma di backdoor, come ad esempio X11/Xorg.
- Fare il backup di tutte le chiavi luks.
- Fare il backup dei volumi luks1 e luks2.
- Fare gli snapshot.
- Smontare l'eventuale /boot/efi all'avvio.
- Configurare /etc/fstab in modo che l'eventuale /boot/efi sia in sola lettura e venga scritto solo in caso di aggiornamenti.
Per i sistemi *BSD la problematica ad oggi non si presenta, in quanto implementano nativamente ZFS boot menu che integra la cifratura tramite GELI
encryption.
Per una documentazione di riferimento è possibile consultare questa pagina.
Kernel
Il kernel è il "cuore" di ogni sistema operativo, è la parte che gestisce l'interazione tra l'hardware e il
software. Nel corso degli ultimi anni, il modo in cui i kernel sono stati progettati si è evoluto per
rispondere a diverse esigenze di prestazioni, modularità e sicurezza.
Storicamente i kernel si possono classificare in kernel monolitici, microkernel e kernel ibridi.
I kernel monolitici sono stati tra i primi ad essere implementati e gestiscono tutte le funzioni di sistema,
come ad esempio la gestione dei dispositivi e della memoria, in un unico blocco di codice.
Questo approccio permette di ottenere prestazioni elevate perché tutti i componenti del sistema sono
strettamente integrati e lavorano insieme nello spazio del kernel.
Tuttavia l'inconveniente è che in caso di problemi di una sola parte del kernel, tutto il sistema ne viene
compromesso, cosa che ha suscitato in passato un dibattito abbastanza acceso tra l'inventore del kernel
Linux, Linus Torvalds, e l'inventore del microkernel Minix, Andrew Tanenbaum.
I microkernel cercano invece di ridurre al minimo le funzioni eseguite all'interno del kernel, delegando la
maggior parte delle operazioni, come ad esempio la gestione dei filesystem o dei driver, a processi separati
nello spazio utente. Questa struttura, anche se garantisce una maggiore sicurezza e stabilità, perché ogni
servizio è isolato, tende ad essere meno efficiente a livello di prestazioni.
Un esempio di microkernel oltre a Minix, è GNU Hurd, che pur essendo nato con grandi ambizioni non ha mai
raggiunto la diffusione di Linux. L'ultimo commit risulta essere del 20
marzo 2021, quindi è comprensibile che anche il supporto hardware risulta essere limitato.
Vi sono poi kernel ibridi che combinano elementi dei kernel monolitici e dei microkernel, che funzionano
principalmente come un kernel monolitico, ma che mantengono una certa modularità per aumentarne la sicurezza
e la stabilità. Kernel ibridi sono ad esempio quelli di Windows NT e di MacOS. Questa soluzione cerca di
bilanciare le prestazioni con la sicurezza.
Android monta un kernel monolitico mentre PostMarketOS e in generale i sistemi operativi basati su GNU/Linux
usano XNUX, che è il kernel di uno sviluppatore chiamato Megi, che tenta di
rimuovere tutti i moduli e le
configurazioni superflue che andrebbero a rallentare e a ridurre le prestazioni del dispositivo. Il kernel
di Megi ha un supporto hardware limitato, ma del resto non
ci sono così tanti sviluppatori di kernel che
contribuiscano a tale progetto.
I sistemi BSD come FreeBSD o OpenBSD, usano un kernel monolitico, ma nonostante ciò adottano policy di
sicurezza sui livelli più alti del sistema operativo. Sia per *BSD che per GNU/Linux è inoltre possibile
impostare il kernel in modalità hardening, il quale consiste principalmente nell'adozione di metodologie
come
W^X, la quale impedisce che una sezione di memoria sia
contemporaneamente scrivibile ed eseguibile allo stesso tempo, riducendo il rischio di attacchi tramite
buffer overflow, oppure nell'implementazione di metodologie come la randomizzazione degli indirizzi di
memoria, così che sia più difficile per un attaccante prevedere dove si trovano i dati sensibili.
Il software SELinux (Security-Enhanced Linux) sarebbe ottimo per la gestione delle
impostazioni del kernel e in generale per la gestione di lettura e scrittura presso le cartelle o i file, se
non fosse che è un software NSA e che quindi potrebbe nascondere al suo interno vulnerabilità ancora non
scovate, messe apposta come backdoor, ed inoltre nella sua gestione risulta abbastanza complesso da gestire,
cosa che spinge molti amministratori di sistema a disabilitarlo. Certo, si potrebbero gestire file e
cartelle, oltre che usando chown e chmod, anche usando chattr, ma è un lavoriaccio che potrebbe
compromettere l'usabilità del sistema operativo stesso.
Per la messa in hardening di GNU/Linux è possibile seguire questa o
questa
guida. Per *BSD invece basta seguire questa, questa, questa, o questa guida.
Sviluppi futuri di Tutanum vedranno impostata in maniera più dettagliata la modalità hardening completa di
GNU/Linux e di *BSD.
Hardening: le indicazioni di Kicksecure
Kicksecure, la base di Whonix, raccoglie le proprie impostazioni di hardening nel pacchetto security-misc, discusso per anni sul forum nella discussione Kernel Hardening. L'idea guida è togliere al kernel ciò che aiuta un exploit senza servire al sistema: informazioni, interfacce poco usate, possibilità di caricare codice. Le voci principali, con il corrispondente su FreeBSD:
| Scopo | Linux (security-misc) | FreeBSD |
|---|---|---|
| Nascondere gli indirizzi e i log del kernel | kernel.kptr_restrict=2, kernel.dmesg_restrict=1 |
security.bsd.unprivileged_read_msgbuf=0 |
| Nascondere i processi altrui | hidepid=2 su /proc |
security.bsd.see_other_uids=0, see_other_gids=0,
see_jail_proc=0 |
| Impedire di ispezionare altri processi | kernel.yama.ptrace_scope=2 |
security.bsd.unprivileged_proc_debug=0 |
| Ridurre le interfacce pericolose | kernel.unprivileged_bpf_disabled=1, kernel.kexec_load_disabled=1 |
Kernel su misura senza i moduli superflui |
| Bloccare il caricamento di moduli | kernel.modules_disabled=1 a fine
avvio | kern.securelevel=1 o superiore |
| Rendere meno prevedibile la memoria | slab_nomerge, init_on_alloc=1, init_on_free=1,
vm.mmap_rnd_bits=32 |
kern.randompid=1, ASLR attivo (kern.elf64.aslr.enable=1) |
| Niente core dump | kernel.core_pattern verso il nulla |
kern.coredump=0, dumpdev="NO" |
Dalle pagine Advanced Host Security, Operating System Hardening e Root vengono poi alcune regole di metodo.
- Tre strati, non equivalenti: ridurre la superficie d'attacco (meno codice, meno servizi, privilegi minimi), difese proattive (compilazione con le protezioni attive, controllo d'accesso obbligatorio, prevenzione delle intrusioni) e difese retroattive (antivirus, IDS, cacciatori di rootkit). Le ultime, avverte Kicksecure, non impediscono una violazione: servono solo a rendere meno probabile la successiva. È l'ordine di priorità seguito anche in Antivirus, EDR e XDR.
- Il sistema appena installato è già vecchio: l'immagine di installazione contiene software con vulnerabilità note, e il primo aggiornamento avviene proprio attraverso la rete meno fidata. Il primo avvio va fatto dietro il firewall, con gli aggiornamenti scaricati attraverso Tor, prima di esporre qualsiasi servizio.
- Il microcodice si aggiorna comunque: è software non libero, ma corregge difetti del processore che nessun altro strato può correggere. Kicksecure lo dice senza giri di parole: in questo caso l'idealismo produrrebbe insicurezza.
- Mai lavorare come root: nessun accesso diretto come root e nessuna shell di root tenuta
aperta. Ogni comando privilegiato si esegue singolarmente (con
doas), da un account di amministrazione distinto da quello d'uso quotidiano, così che un malware nell'account normale non possa intercettare la password privilegiata. - Rete separata: se la rete di casa è condivisa con altri dispositivi, il nodo sta in una zona isolata (DMZ) da cui non vede stampanti, telefoni e computer, e non ne è visto. Limita i danni di un'intrusione, non protegge l'anonimato.
FreeBSD: nucleo del kernel, dispositivi grezzi e filesystem
La pagina di manuale security(7) di FreeBSD parte da un'ipotesi scomoda:
l'intruso è già root. A quel punto può fare quasi tutto, ma alcune comodità gli si possono togliere.
Sono quattro: il dispositivo bpf, con cui si intercetta il traffico; /dev/mem
e /dev/kmem, con cui si legge e si scrive la memoria; i dischi grezzi, su cui si scrive
scavalcando il filesystem; il caricatore di moduli kldload, con cui si aggiunge al
kernel in esecuzione qualunque cosa, compreso un bpf che non c'era.
Il livello di sicurezza del kernel
La risposta è il securelevel. Qualunque processo di root può alzarlo, nessuno può abbassarlo fino al riavvio.
| Livello | Che cosa impedisce, in più del precedente | Conseguenze per Tutanum |
|---|---|---|
| -1 e 0 | Nulla: i flag di immutabilità si possono togliere, i dispositivi si aprono secondo i permessi | Solo durante l'installazione e la manutenzione |
| 1 | Togliere i flag schg e sappnd; scrivere su
/dev/mem, /dev/kmem e sui dischi dei filesystem montati;
aprire /dev/io; caricare o scaricare moduli; entrare nel debugger o
forzare un panic | Non basta per un nodo: i dischi non montati restano scrivibili, compresa la partizione con il codice di avvio, che sta fuori dalla parte cifrata. I moduli vanno caricati all'avvio |
| 2 | Scrivere su qualunque disco, montato o no; spostare l'orologio di più di un
secondo per volta, o più di una volta al secondo, e riportarlo indietro. Su FreeBSD 15,
inoltre, ogni modifica a pf: regole, àncore, nuovi indirizzi nelle tabelle, chiusura
delle connessioni, pfctl -d | Il livello dell'host. Il codice di avvio non si può più sostituire; pf resta quello caricato all'avvio, e ciò che deve cambiare passa dalle tabelle di ipfw; l'orologio va regolato prima che il livello salga, e dopo recupera al massimo un secondo al secondo |
| 3 | Cambiare le regole e le tabelle di ipfw, e la configurazione di pf e dummynet | Il firewall diventa del tutto immutabile, tabelle comprese: niente più bando automatico né contenimento sulla rete |
Gli script di contenimento e dell'honeypot isolano un indirizzo aggiungendolo a una tabella del firewall, e sshguard fa lo stesso. Su FreeBSD 15 la scelta della tabella non è indifferente, ed è stata provata su una 15.1: pf, che ormai si comanda via netlink, dal livello 2 rifiuta nuovi indirizzi nelle tabelle, nuove regole e la chiusura delle connessioni, mentre le tabelle di ipfw restano modificabili fino al livello 2 compreso. In più ipfw esamina ogni pacchetto, quindi un indirizzo messo in quarantena perde anche le connessioni già aperte, che pf lascerebbe proseguire. Le posture possibili sono due.
- Host a livello 2, jail a livello 3: ogni jail ha un securelevel proprio, che può essere più alto di quello dell'host. I servizi esposti girano così nel regime più severo, l'host protegge il proprio codice di avvio, pf resta la politica fissa caricata all'avvio e le tabelle di ipfw conservano la capacità di reagire. È la postura consigliata, ed è quella di Tutanum Classico. Il livello si alza all'ultimo passo dell'installazione: prima, con pf congelato, non si potrebbero più scaricare i pacchetti.
- Host a livello 3: anche ipfw si congela, tabelle comprese. Niente bando automatico, niente contenimento sulla rete: resta il congelamento dei processi, e l'isolamento si sposta sul router. Ha senso per un nodo che non cambia mai e che si preferisce rigido piuttosto che reattivo.
File immutabili
Il securelevel protegge i flag, non i file. Perché serva, tutto ciò che viene eseguito dall'accensione
fino al momento in cui il livello sale deve avere il flag schg: altrimenti all'intruso
basta modificare uno script di avvio e riavviare. Il manuale avverte subito del prezzo: aggiornare un
sistema così diventa molto più laborioso, e non conviene marcare ogni file "sotto il sole".
# ciò che gira prima che il securelevel salga: kernel, caricatore, init, script e configurazione di avvio
doas chflags -R schg /boot/kernel /boot/loader /boot/loader.conf /boot/loader.conf.d /boot/lua /boot/defaults
doas chflags -R schg /sbin /bin /lib /libexec /usr/bin /usr/sbin /usr/lib /usr/libexec
doas chflags -R schg /etc/rc.d /usr/local/etc/rc.d /etc/defaults /etc/rc.conf.d
doas chflags schg /etc/rc /etc/rc.subr /etc/rc.conf /etc/sysctl.conf /etc/fstab /etc/ttys \
                  /etc/pf.conf /etc/ipfw.rules /etc/login.conf /usr/local/etc/doas.conf \
                  /etc/rc.local /etc/crontab /etc/rctl.conf /etc/ipfw.mai_bloccare
# rc.local, defaults e rc.conf.d girano prima del securelevel, che sale per ultimo (rcorder)

ls -lo /sbin/init /etc/rc.conf          # la colonna dei flag deve mostrare "schg"
Per aggiornare si riavvia in modalità utente singolo, dove il livello non è ancora salito, si tolgono
i flag con chflags -R noschg, si aggiorna, si rimettono e si riavvia. I registri si
possono proteggere con sappnd, che permette solo di aggiungere in coda, ma la rotazione
dei log smette di funzionare: conviene piuttosto spedirli fuori dal nodo.
Il manuale propone un'alternativa più semplice: montare / e /usr in sola
lettura. Con ZFS è una proprietà del dataset (zfs set readonly=on), ma root può
toglierla a sistema avviato, quindi ferma gli errori e il malware ordinario, non un intruso che
sa quello che fa. E chiude con un avvertimento che vale per tutta la sezione: essere troppo
draconiani in ciò che si protegge può impedire la cosa più importante, cioè accorgersi
dell'intrusione. Un sistema che non si riesce più ad aggiornare né a ispezionare non è più
sicuro.
bpf e memoria
Il manuale consiglia di non compilare bpf nel kernel. Su un nodo Tutanum la cosa ha un
costo preciso: senza bpf non funzionano il client DHCP né tcpdump, che gli
script di difesa usano per leggere il registro di pf. Anche qui le posture sono due.
- Tenerlo, ma solo sull'host:
/dev/bpfè accessibile al solo root, e le jail non lo vedono affatto se usano il set di regole predefinito di devfs. Chi compromette un servizio in una jail non può intercettare nulla. È la postura consigliata, perché conserva la capacità di osservare. - Toglierlo: kernel su misura con
nodevice bpf, indirizzo statico al posto di DHCP, e rinuncia alla lettura in tempo reale del registro di pf. Con il securelevel almeno a 1 non può essere ricaricato come modulo.
# le jail non devono vedere bpf, mem, kmem e io: lo garantisce il set di regole 4 di devfs
grep -A12 "devfsrules_jail=4" /etc/defaults/devfs.rules
doas jexec web ls /dev            # -> nessun bpf, mem, kmem, io
Manopole e regolazioni
La sezione "Knobs and tweaks" del manuale elenca i parametri che limitano ciò che un processo può sapere degli altri e quelli che attivano le mitigazioni per le fughe di informazioni dell'hardware. Eccoli tutti, con il valore per un nodo Tutanum.
| Parametro | Che cosa controlla | Valore |
|---|---|---|
security.bsd.see_other_uids, see_other_gids |
Se un utente vede processi e socket di altri utenti o gruppi | 0 |
security.bsd.see_jail_proc | Lo stesso, tra jail e sotto-jail | 0 |
security.bsd.conservative_signals | Ai programmi che hanno cambiato utente si possono inviare solo i segnali di terminazione e di controllo | 1 |
security.bsd.unprivileged_proc_debug | Il debug dei processi per chi non è root | 0 |
kern.elf64.aslr.enable, pie_enable, stack |
Randomizzazione degli indirizzi per eseguibili, eseguibili indipendenti dalla posizione e stack | 1 |
kern.elf64.aslr.honor_sbrk | Rende la randomizzazione meno aggressiva per compatibilità con programmi vecchi | 0 |
kern.elf64.nxstack | Stack non eseguibile | 1 |
kern.elf64.allow_wx | Pagine di memoria insieme scrivibili ed eseguibili: è il principio W^X visto sopra | 0 |
vm.pmap.pti | Isolamento delle tabelle delle pagine contro Meltdown (si imposta all'avvio) | 1 |
hw.ibrs_disable | Mitigazione di Spectre v2 | 0, cioè attiva |
hw.mds_disable | Mitigazione di MDS | 3, scelta automatica |
hw.spec_store_bypass_disable | Mitigazione di Spectre v4 | 2, automatica |
machdep.mitigations.flush_rsb_ctxsw | Svuotamento del buffer degli indirizzi di ritorno al cambio di contesto | Predefinito |
machdep.syscall_ret_flush_l1d | Svuotamento della cache L1D al ritorno dalle chiamate di sistema fallite: il manuale stesso la chiama un'impostazione paranoica | 1 |
machdep.mitigations.rngds.enable | Mitigazione delle fughe dai registri speciali (RDRAND, RDSEED) | 1 |
hw.vmm.vmx.l1d_flush, machdep.nmi_flush_l1d_sw |
Mitigazione di L1 Terminal Fault per bhyve | 1, se si usa bhyve |
vm.pmap.allow_2m_x_ept | Superpagine eseguibili per gli ospiti, legate a un difetto di alcune CPU Intel | 0, se si usa bhyve su CPU interessate |
Le versioni a 32 bit (kern.elf32.*) seguono gli stessi valori. Un avvertimento:
allow_wx=0 impedisce di funzionare ai programmi che generano codice mentre girano
(compilatori JIT). Su un server è quasi sempre ciò che si vuole, ma va provato servizio per servizio.
Il manuale aggiunge una riserva onesta: alcuni considerano queste regolazioni un miglioramento della
sicurezza, e non tutti. Sono ostacoli, non garanzie.
Resta infine ciò che il manuale dice del controllo d'integrità: farlo da un'altra macchina fidata, che legge il nodo dall'esterno, perché un controllo eseguito dal sistema compromesso può essere falsificato. È lo stesso principio seguito in Che cosa insegna Whonix.
Init system
L'init system è quel servizio che parte per primo che procede ad avviare tutti gli altri servizi.
Il più diffuso è systemd, ma è complesso da configurare, non rispetta la filosofia KISS e va a gestire molto
di più rispetto ai semplici servizi fondamentali del sistema operativo, oltre che fungere spesso da logger
massivo
degli eventi di sistema.
Systemd, ma anche DBUS, sono pieni di bug, anche gravi seppur
non RCE e sono
strutturati per lo spionaggio: systemd controlla e logga
tutto a livello di sistema ed anche di risoluzione DNS, quindi ha la possibilità di sapere cosa accade a
livello del sistema operativo e dove si naviga in rete.
Whonix è un sistema operativo orientato all'anonimato, ma presenta ancora delle criticità come l'utilizzo di
systemd e di dbus. La loro documentazione relativa alla privacy e all'anonimato sono ottime, ma le decisioni
rispetto a queste due scelte lo rendono un sistema operativo di per sé potenzialmente vulnerabile.
Le alternative a systemd più conosciute sono OpenRC, SysVinit e UpStart.
In ambiente BSD si usa Runcom, abbreviato solitamente ad RC (la cui configurazione è /etc/rc.conf), mentre
alcune distro Linux come Gentoo offrono la possibilità di decidere l'init system preferito.
Distribuzioni come Arch Linux o Debian usano di default systemd e per questo ad oggi si sono costruite delle
fork chiamate rispettivamente Artix Linux e Devuan, di cui tuttavia presentano entrambe un problema comune:
hanno una scarsa documentazione che avrebbero potuto scrivere da più di 10 anni a questa parte, con la scusa
che sono per l'appunto delle fork. Sarebbe ovviamente possibile cambiare l'init system su altre
distribuzioni che non consentirebbero di default di poterlo fare, tuttavia sarebbe abbastanza difficoltoso
effettuare alcune installazioni e configurazioni, il che rende tali possibilità ancora remote per molte
distribuzioni.
Void Linux usa Runit che è di per sé abbastanza limitato e non supporta policy di sicurezza avanzate.
IPC (comunicazione tra i processi)
DBUS è la centralizzazione
(single point of failure) dei
flussi tra i software, è il software più utilizzato per la messaggistica
interprocesso (IPC) e viene impiegato come sostituto rispetto al vecchio sistema unidirezionale basato su
pipe.
È come un hub sulla quale passa di tutto, gli stream sono tutti in chiaro e qualsiasi software in
ascolto su DBUS può sapere qualsiasi informazione ancora prima dell'eventuale cifratura.
Ad oggi,
soprattutto per uso desktop, a causa dell'impiego di default di FreeDesktop.org, risulta difficile eseguire
applicazioni desktop, in quanto includono come dipendenza proprio il pacchetto DBUS.
DBUS è stato pensato praticamente in concomitanza con GNOME, l'ambiente desktop di default usato nei
prodotti desktop dell'azienda Red Hat.
L'IPC è stato sviluppato presso l'azienda FreeDesktop.org, fondata nel marzo del 2000 da Havoc Pennington,
ingegnere di Red Hat.
È possibile comprendere pertanto l'influenza di tale azienda nell'ambito desktop.
LXQT, QT4, GTK3, Mate, KDE Plasma, GNOME, etc. usano tutti DBUS, ed oltre a questi, anche applicazioni come
Firefox,
Chromium e le relative fork usano DBUS.
Ci sarebbe la possibilità di compilare Firefox senza DBUS in modo che usi Pipe ma online attualmente non vi
è documentazione
alcuna: Firefox dipende da GTK3+ che dipende a sua volta da
at-spi2-atk che dipende a sua volta da DBUS. A livello desktop l'unico che non implementa DBUS è una fork di
Lumina
Desktop chiamata 7b7b, ma a livello server non dovrebbe servire. Lumina desktop è diventato ports
per FreeBSD e implementa di default DBUS.
Per l'installazione di Gentoo senza
DBUS è possibile consultare questo
thread.
Polkit
Polkit, noto anche come PolicyKit, è un framework
sviluppato da freedesktop.org (gli stessi di dbus), che
gestisce l'autorizzazione per eseguire azioni
privilegiate in ambienti desktop moderni.
Ha come problema principale il fatto che gestisca i privilegi dei singoli applicativi per mezzo di file (di
policy) di
configurazione (in XML) che aumenta la complessità di gestione dei privilegi stessi.
Nel caso di utilizzo di polkit è richiesto anche l'utilizzo di dbus, pertanto una vulnerabilità su polkit
porta alla compromissione di tutto il sistema operativo, cosa già accaduta con la CVE-2021-3560.
GLIBC
Glibc è una dipendenza di Polkit, il che
significa che compromesso glibc è possibile compromettere anche quest'ultimo e pure dbus, con i relativi
privilegi amministrativi e tutti gli applicativi a seguire.
Tale libreria inoltre è ormai tristemente nota per essere, alla stregua di grub, piena di bug. Nel solo 2023
sono emerse 8 vulnerabilità:
- CVE-2023-4911: buffer overflow nel dynamic loader di glibc, sfruttabile tramite la variabile GLIBC_TUNABLES, che consente di ottenere privilegi di root. Questo problema è stato introdotto con glibc 2.34 ed è stato confermato su varie distribuzioni come Fedora, Ubuntu e Debian.
- CVE-2023-4813: vulnerabilità legata a un heap-based buffer overflow nella funzione getaddrinfo(). Sfruttabile da attaccanti remoti, questa vulnerabilità potrebbe causare esecuzione di codice arbitrario o crash del sistema.
- CVE-2023-4806: problema di corruzione della memoria che si verifica durante l'uso della funzione strxfrm(). Questa vulnerabilità potrebbe consentire agli attaccanti di eseguire codice arbitrario.
- CVE-2023-4193: stack-based buffer overflow nella funzione locale() in glibc, che consente l'esecuzione di codice in modalità elevata su sistemi vulnerabili.
- CVE-2023-4157: vulnerabilità relativa alla gestione errata della memoria durante la conversione di set di caratteri, potenzialmente sfruttabile per eseguire codice arbitrario.
- CVE-2023-4572: un problema nella gestione delle funzioni di risoluzione dei nomi di dominio che consente a un attaccante remoto di causare un crash o eseguire codice.
- CVE-2023-4210: stack overflow nella funzione nscd (Name Service Cache Daemon) di glibc che può essere sfruttato per eseguire codice con privilegi elevati.
- CVE-2023-4291: vulnerabilità di out-of-bounds read nella funzione iconv(), che potrebbe essere sfruttata per eseguire codice arbitrario su sistemi vulnerabili.
Lasciamo qui invece la lista delle RSA del 2024. Il tutto fa comunque pensare che glibc non sia sicuro e che un utilizzo di alternative come musl (implementato di default sia da Void Linux che da Alpine Linux) sia sicuramente migliore.
Privilegi amministrativi
Il pacchetto di default utilizzato nelle distribuzioni GNU Linux è sudo.
Per Tutanum è raccomandato l'uso di un sistema operativo che non usi
quest'ultimo ma piuttosto software come
doas, in
quanto ha molti meno bug
rispetto al suo concorrente, implementa una filosofia granulare, chiara e pulita in modo che
possa essere modificato semplicemente, permette l'attribuzione di singoli comandi di
amministrazione per determinati utenti ed in maniera semplice e non è necessario conoscere il C
per effettuare modifiche approfondite: i sistemi operativi che implementano nativamente doas
sono Alpine Linux, Devuan, OpenBSD, NetBSD e FreeBSD. Devuan è tuttavia da scartare in
quanto, come già detto, dopo più di 10 anni non c'è ancora una documentazione sufficiente a garantire una
corretta
mantenibilità del progetto, con la scusa che derivino da Debian (risulta molto difficile per
esempio fare alcune configurazioni usando sysvinit al posto di systemd).
Configurare doas.conf
Tutta la configurazione di doas è un file di poche righe: /etc/doas.conf su OpenBSD,
/usr/local/etc/doas.conf su FreeBSD. Ogni riga è una regola, e vale l'ultima che
corrisponde. Se nessuna corrisponde, il comando è negato.
| Elemento | Significato |
|---|---|
permit, deny | Consente o nega |
utente, :gruppo | A chi si applica la regola |
as root | L'utente di destinazione |
cmd, args | Limita la regola a un comando, e a una precisa sequenza di argomenti |
nopass | Non chiede la password: solo per comandi singoli e innocui |
persist | Ricorda l'autenticazione per qualche minuto. Nasce su OpenBSD e nei port per altri sistemi può mancare |
keepenv, setenv | Conservano o impostano variabili
d'ambiente. keepenv va evitato: l'ambiente dell'utente entra nel
comando privilegiato |
Il valore di doas sta nella granularità: non un utente che può tutto, ma ruoli che possono ciò che serve loro.
# /usr/local/etc/doas.conf

# l'amministratore: tutto, sempre con la password
permit operatore as root

# un ruolo di sola osservazione: pochi comandi di lettura, senza password, niente altro
permit nopass osservatore as root cmd /sbin/pfctl args -sr
permit nopass osservatore as root cmd /sbin/pfctl args -si
permit nopass osservatore as root cmd /usr/sbin/service args tor status
permit nopass osservatore as root cmd /usr/sbin/jls

# il backup programmato: un solo comando, con quegli argomenti esatti
permit nopass copie as root cmd /sbin/zfs args snapshot -r zroot@giornaliero

# l'EDR: chi riceve gli avvisi può rilasciare o eliminare un caso, ma non fare altro
permit reperibile as root cmd /usr/local/sbin/tutanum-edr

# vale l'ultima regola che corrisponde: questa toglie lo spegnimento anche all'amministratore remoto
deny operatore as root cmd /sbin/shutdown
doas chown root:wheel /usr/local/etc/doas.conf && doas chmod 600 /usr/local/etc/doas.conf
doas -C /usr/local/etc/doas.conf                        # controlla la sintassi: nessun output = corretta
doas -C /usr/local/etc/doas.conf pfctl -sr              # quale regola si applica a questo comando?
doas -C /usr/local/etc/doas.conf sh                     # per "osservatore" deve rispondere: deny
Tre regole di prudenza. Un comando con nopass non deve mai poter aprire una shell o
scrivere un file a scelta dell'utente: un editor, tar o find concessi
senza password equivalgono a concedere tutto. I percorsi dei comandi si scrivono per intero, così
che non dipendano dal PATH di chi li invoca. E ogni jail ha il proprio
doas.conf, con un utente di gestione che vale solo lì dentro: i privilegi dell'host non
entrano nelle jail e viceversa. Ogni uso di doas finisce nel registro di sistema, ed è una sorgente
per il monitoraggio.
Gestione degli utenti e dei gruppi
La gestione degli utenti e dei gruppi riguarda due punti ben distinti: la configurazione locale e l'accesso
da remoto.
Per quanto riguarda la configurazione locale, avere un utente nel gruppo wheel consente ad un potenziale
intruso di ottenere l'accesso a root nel caso riesca a ottenere il file delle password e a compromettere un
account del personale. Pertanto è necessario utilizzare con parsimonia l'accesso degli utenti a wheel e
configurare in maniera ragionata i permessi utilizzando i dovuti strumenti come chown e chmod.
È inoltre importante impostare il rinnovo password almeno una volta ogni 90 giorni (3 mesi, un quarto di
anno).
Per quanto riguarda le configurazioni di accesso da remoto invece è consigliato limitare gli accessi a root
dall'esterno, in modo che root possa essere eseguito solo tramite tastiera collegata alla macchina, così che
vi accedano da remoto (ma sempre in LAN) le utenze nominali.
La documentazione di FreeBSD consiglia di
consentire l'accesso o via SSH usando una coppia di
chiavi privata e pubblica, oppure tramite Kerberos, usando il file .k5login nell'account root per
consentire l'accesso agli utenti con ksu a root senza dover inserire nessuno nel gruppo wheel.
Il messaggio di accesso (motd) e le jail
All'accesso un sistema appena installato si presenta: nome, versione del kernel, data di compilazione, un invito a leggere il manuale. Sono informazioni regalate a chiunque ottenga una sessione, anche limitata, e la versione esatta del kernel è la prima cosa che cerca chi vuole scegliere un exploit. Il messaggio va quindi svuotato di tutto ciò che descrive il sistema.
Dentro le jail il messaggio ha però una funzione utile, che conviene tenere: dire all'operatore dove si trova. Con cinque o sei jail aperte, il comando giusto nella jail sbagliata è l'errore più facile da commettere. Il messaggio di una jail dice dunque il ruolo, e nient'altro: nessun nome del progetto, nessun nome host, nessuna versione.
# /etc/motd.nodo (sull'host)
host. Qui non gira alcun servizio: ogni servizio ha la propria jail.
Ogni comando privilegiato passa da doas e viene registrato.

# /etc/motd.nodo (nella jail web)
jail: web. Server web, nessuna uscita verso la rete.
Ogni comando privilegiato passa da doas e viene registrato.
# FreeBSD: il messaggio predefinito viene rigenerato a ogni avvio con la versione del kernel in testa
doas sysrc update_motd=NO
# /etc/login.conf, classe "default": si mostra il file statico e si toglie l'avviso di copyright
#     :welcome=/etc/motd.nodo:\
#     (rimuovere la riga :copyright=/etc/COPYRIGHT:\)
doas cap_mkdb /etc/login.conf

# lo stesso in ogni jail, dall'host
for j in tor i2p web iop esca; do
    doas jexec $j sysrc update_motd=NO
    doas jexec $j cap_mkdb /etc/login.conf
done

# /etc/ssh/sshd_config: nessun banner, e nessuna aggiunta alla stringa di versione
Banner none
VersionAddendum none
Si verifica aprendo una sessione: deve comparire solo il testo scelto. Lo stesso vale per il prompt
della console, che per impostazione predefinita mostra sistema e nome host prima ancora del login
(su FreeBSD si cambia nella voce default di /etc/gettytab). Il messaggio di
una jail esca è l'eccezione: lì deve sembrare quello di un sistema qualunque, perché
deve ingannare.
Password
La best practice relativa alla scelta di una password riguarda quanto segue:
Teniamo da conto che oltre i 10 caratteri vi è difficilmente la possibilità
di operare in brute force, a meno di ottenere un dizionario che sia in linea
con una certa probabilità di trovare i termini giusti. Tuttavia il trucco
migliore è quello di creare una passphrase complessa ma ricordabile
facilmente.
Ad esempio tre parole concatenate tra loro, più dai 2 ai 4 numeri e almeno un
carattere speciale.
I caratteri casuali (randomici) sono impossibili da ricordare mentalmente, il che
implicherebbe di doverla scrivere da qualche parte, vanificando la sicurezza
della stessa.
Qui di seguito si possono analizzare tre esempi nominati caso A (passphrase con
caratteri casuali e impossibile da ricordare), caso B (passphrase impossibile da
decriptare da brute force) e caso C (passphrase basata sulla regola delle tre
parole più almeno 4 numeri e almeno un carattere speciale, ma basata su un
cosiddetto dialetto o lingua locale, di cui difficilmente esiste un dizionario).
Caso A:
"Ajfkro10m%xbwhe!": 16 caratteri ma impossibile da ricordare, non è
decriptabile
da brute force poiché non esiste un dizionario per decriptarla, ma la si dovrà
segnare da qualche parte e probabilmente in chiaro. La soluzione dei portachiavi
è un problema enorme (vedi bug) e presenta un single point of failure espresso
dall'accesso a tutte le password nel caso si venga a conoscenza della password
principale del portachiavi (password manager).
Caso B:
"GiornoInBestia8!": 16 caratteri e facilmente ricordabile, non esistono
dizionari per tali combinazioni di 3 parole. Naturalmente va fatta una scelta
cum grano salis (usando il buon senso): è difficile che ci sia una tale
combinazione di parole, ma è chiaro che è nota la frase "BellaGiornata", per
esempio.
Caso C:
"PotrangaInOcho8!": 16 caratteri, non difficile da ricordare, tre parole
da due cosiddetti dialetti o lingue locali, 1 numero e 1 carattere speciale.
Impossibile da decriptare poiché non esistono dizionari per brute force. Usare
pertanto un dialetto o combinazioni di dialetti.
Tenere anche da conto la possibilità di usare il leet per la scrittura delle
parole e quindi dell'utilizzo di caratteri numerici al posto di alcuni caratteri
alfabetici:
            A: 4, /\, @, /-\, ^, ä, ª, aye, ∂, Fl, O
            B: 8, 6, 13, |3, ß, P>, |:, !3, (3, /3, )3
            C: [, ¢, <, (, ©
            D: |), o|, [), I>, |>, ?, T), /)
            E: 3, &, £, ë, [-, €, ê, |=-
            F: 4, |=, ƒ, |#, i=, ph, /=
            G: 6, &, (_+, 9, C-, gee, (γ,
            H: 4, #, /-/, [-], ]-[, )-(, (-), :-:, |~| {=}, <~>, |-|, ]~[, }{ , ]-[, ?, }-{
            I: 1, !, |, &, eye, 3y3, ï, ][, []
            J: _|, ;, _/, </, (/
            K: X, |<, |{, ]{, }<, /< , |(
            L: 2, £, 7, 1_, |, |_, #, l, i, \_
            M: M, m, //., |v|, [V], {V}, |\/|, /\/\, (u), []V[], (V), (\/), /|\, Μ, м, /V\,
            N: //, ^/, |\|, |/|, /\/, [\], , <\>, {\}, []\[], И, n,/V, ₪
            O: 0, (), ?p, [], *, ö
            P: |^, |*, |o, |º, |^(o), |>, |", 9, []D, |̊, |7 |°
            Q: [,], (_,), ()_, 0_, <|, O-
            R: |2, P\, |?, /2,|^, lz, ®, [z, 12, Я, 2, |>\
            S: 5, 2, $, z, §, ehs, es
            T: 7, +, -|-, 1, '][', "|", †
            U: (_), |_|,|.|, v, ü Ü
            V: \/, \_/, \./
            W: \/\/, vv, '//, \^/, (n), \V/, \//, \X/, \|/, \_|_/, \_:_/, \x/, I_l_I, Ш, VV
            X: ><, Ж, }{, )(, ×
            Y: '-/, j, `/, \|, Ý, ÿ, ý, Ŷ, ŷ, Ÿ, Ϋ, Υ, Ψ, φ, λ, Ұ, ұ, ў, ץ ,צ, -), Ч, ¥
            Z: 2, ~\_, ~/_,7_, %
Ovviamente in caso di keylogger viene compromessa naturalmente l'integrità della sicurezza di Tutanum, per questa ragione è bene rispettare una filosofia KISS, minimalista e le best practice riguardanti la messa in hardening dei sistemi operativi.
Crittografia
La crittografia è l'ultima linea quando tutto il resto cede: un disco sequestrato o un flusso intercettato restano illeggibili solo se la cifratura è solida. Ma è forte solo quanto le sue chiavi, la sua casualità e le sue implementazioni.
Cifratura dell'intero disco
Cifrare tutto, inclusa la swap, con geli (FreeBSD) o LUKS (Linux) e un cifrario standard come AES-XTS, con autenticazione prima dell'avvio. Attenzione a dove vive la chiave: in RAM è esposta agli attacchi cold boot.
# FreeBSD: inizializzare e aprire un disco cifrato con geli
doas geli init -s 4096 -l 256 /dev/ada1
doas geli attach /dev/ada1
# Linux: LUKS
doas cryptsetup luksFormat /dev/sdb
doas cryptsetup open /dev/sdb cifrato
Casualità ed entropia
Un generatore di numeri casuali debole o con backdoor rompe qualsiasi cifratura. Il caso più noto è Dual_EC_DRBG, uno standard con una backdoor
attribuita alla NSA. Conviene quindi usare il generatore del kernel (getrandom,
/dev/urandom), non fidarsi ciecamente del solo RNG hardware della CPU (RDRAND) ma
mescolarlo con altre fonti, e garantire entropia sufficiente all'avvio (jitterentropy).
# Linux: entropia disponibile (dovrebbe essere alta e stabile)
cat /proc/sys/kernel/random/entropy_avail
Gestione delle chiavi
Le chiavi sono il vero segreto: vanno conservate fuori banda, mai in chiaro sul disco che proteggono, ruotate periodicamente e, per i segreti più critici, suddivise con uno schema a soglia (Shamir), così che nessuno da solo le possieda. Diffidare dei token hardware proprietari: aggiungono un terzo di cui fidarsi.
Harvest now, decrypt later
Un avversario statale registra oggi il traffico cifrato per decifrarlo domani, quando avrà la chiave o un computer quantistico abbastanza potente. Le contromisure sono la forward secrecy (già presente in Tor e I2P, che rinnovano le chiavi di sessione), l'uso di scambi di chiavi post-quantum o ibridi (ad esempio X25519 unito a ML-KEM) dove disponibili, e il non affidare dati sensibili a chiavi di lunghissima durata.
Principi
Usare solo algoritmi standard e ben analizzati, mai crittografia fatta in casa; preferire implementazioni libere e verificate; attivare la forward secrecy; cancellare in modo sicuro le chiavi quando non servono; e diffidare di uno standard spinto con insistenza ma senza spiegazioni, come insegna proprio Dual_EC_DRBG.
Anti-forensics ed emergenza
La cifratura protegge i dati finché la chiave resta segreta. Ma uno degli scenari del modello di minaccia è la coercizione diretta sull'operatore. Qui la domanda non è più come proteggere i dati, ma come renderli irrecuperabili in fretta e come non lasciare tracce utili a un'analisi forense.
Cancellazione sicura e crypto-erase
Su un disco cifrato non serve sovrascrivere ogni byte: basta distruggere la chiave. Se l'intero disco è cifrato, azzerare l'header e gli slot delle chiavi rende il contenuto rumore indistinguibile, in modo istantaneo (crypto-erase). Per i singoli file su supporti non cifrati valgono gli strumenti di sovrascrittura, tenendo presente che su SSD e con copy-on-write la sovrascrittura è inaffidabile per via del wear leveling, ragione in più per cifrare tutto fin dall'inizio.
# Linux: distruggere gli slot chiave di un volume LUKS (crypto-erase)
doas cryptsetup erase /dev/sdb
doas dd if=/dev/urandom of=/dev/sdb bs=1M count=16   # sovrascrive l'header residuo
Distruzione di emergenza e dead-man switch
Prevedere in anticipo una procedura rapida: un comando o una combinazione fisica che smonta i volumi, scarta le chiavi dalla RAM e spegne la macchina. Un dead-man switch spegne o cancella se l'operatore non conferma periodicamente la propria presenza. Vanno provati a freddo: una procedura di emergenza mai collaudata non funziona quando serve.
Negabilità e minimizzazione delle tracce
Meno dati esistono, meno se ne possono sequestrare. Minimizzare i log e cifrare la swap evita che chiavi e frammenti sensibili finiscano su disco in chiaro. La cosiddetta cifratura negabile (volumi nascosti) va trattata con cautela: raramente regge contro un avversario che sa cosa cercare e può costituire di per sé un indizio. La difesa più solida resta non possedere ciò che non serve, come nel principio OPSEC del need-to-know verso sé stessi.
Analisi forense della memoria
Un sequestro a macchina accesa consente l'acquisizione della RAM con chiavi e dati in chiaro, la stessa superficie degli attacchi cold boot. Da qui l'importanza di spegnere davvero i nodi sensibili quando non servono e di non lasciarli in sospensione in luoghi accessibili.
Resilienza al sequestro di un nodo
Rendere i dati irrecuperabili è metà del problema, perché l'altra metà è che il sistema nel suo insieme sopravviva alla perdita fisica di un nodo. Qui torna utile l'antiscalabilità, dato che una rete di molti piccoli nodi indipendenti sopporta il sequestro di uno solo assai meglio di un unico server che concentra tutto, a patto di progettare in anticipo tre cose: che il nodo preso non consegni le chiavi degli altri, che il servizio continui altrove e che un nodo nuovo possa ricostruire ciò che serve.
Compartimentazione della fiducia: un nodo sequestrato va considerato interamente compromesso, quindi non deve custodire alcun segreto condiviso, il che significa chiavi distinte per ogni nodo, nessuna chiave maestra comune, certificati SSH a vita breve emessi da una CA tenuta fuori dai nodi esposti e segretezza in avanti sui servizi, così che il traffico passato resti indecifrabile anche con la chiave trovata. Appena un nodo è perso, le sue credenziali vanno revocate ovunque.
Ridondanza e distribuzione geografica: il servizio va replicato su nodi collocati su reti e, dove possibile, giurisdizioni diverse, come vuole il valore della decentralizzazione, affinché la caduta di uno non interrompa il servizio e non riveli gli altri. Un nodo nuovo riprende il lavoro ricostruendo i dati tracciati dagli altri tramite iop su I2P in modalità fail-closed, con tutto versionato e verificabile, senza dover esporre un server centrale.
Dead-man switch fisico: oltre alla procedura manuale già citata, un cavo a strappo magnetico in stile BusKill trasforma la rimozione improvvisa della macchina in un evento di distacco USB che stacca i volumi cifrati e spegne. Su FreeBSD lo si realizza con una regola di devd.
# /usr/local/etc/devd/buskill.conf
notify 100 {
    match "system"    "USB";
    match "subsystem" "DEVICE";
    match "type"      "DETACH";
    match "vendor"    "0xXXXX";
    match "product"   "0xYYYY";
    action "/usr/local/sbin/buskill.sh";
};
#!/bin/sh
# /usr/local/sbin/buskill.sh: stacca i volumi cifrati e spegne subito.
for p in $(geli status | awk '/ACTIVE/ {print $1}'); do
    geli detach -f "$p"
done
/sbin/shutdown -p now
PoC di verifica: un secondo dead-man switch, software, basato su un battito, così che se l'operatore non conferma la propria presenza entro una soglia la macchina stacchi le chiavi e si spenga da sola. Va provato a freddo, come ogni procedura di emergenza.
#!/bin/sh
# In cron ogni 5 minuti. L'operatore conferma la presenza con:  touch /var/run/presenza
limite=1800                                   # 30 minuti
mtime=$(stat -f %m /var/run/presenza 2>/dev/null || echo 0)
if [ "$(( $(date +%s) - mtime ))" -gt "$limite" ]; then
    for p in $(geli status | awk '/ACTIVE/ {print $1}'); do geli detach -f "$p"; done
    /sbin/shutdown -p now
fi
La regola generale è trattare ogni nodo sequestrato come una fonte di compromissione per tutto ciò che ha toccato, ruotando di conseguenza le credenziali condivise e le chiavi dei servizi, nello stesso spirito dell'anti-forensics appena descritto.
Verifica e integrità del software
Tutta la sicurezza di Tutanum poggia sul software che gira davvero sulla macchina. Se quello che si installa non è quello che gli autori hanno scritto, ogni altra misura è inutile. Il problema è reso celebre dal Reflections on Trusting Trust di Ken Thompson: in teoria non ci si può fidare di codice che non si è compilato personalmente, e nemmeno, ricorsivamente, del compilatore stesso.
Firme e somme di controllo
Verificare sempre la firma crittografica e la somma di controllo di ciò che si scarica, confrontando la chiave con fonti indipendenti e non solo con quella fornita dallo stesso sito. I gestori di pacchetti delle distribuzioni serie firmano i pacchetti: non disattivare mai questa verifica.
# Verificare firma GPG e checksum di un'immagine scaricata
gpg --verify immagine.iso.sig immagine.iso
sha256sum --check immagine.iso.sha256
Build riproducibili e bootstrap
Una build è riproducibile quando chiunque, partendo dallo stesso sorgente, ottiene bit per bit lo stesso binario: così tutti possono verificare che il binario distribuito corrisponde davvero al codice pubblico, e nessuna backdoor può essere iniettata in fase di compilazione senza che si noti. I progetti di bootstrappable build affrontano direttamente il problema del compilatore fidato, ricostruendo l'intera catena da un seme minimo e ispezionabile. Preferire software e distribuzioni che adottano queste pratiche.
Integrità nel tempo
Oltre al momento dell'installazione, conta che il sistema non venga alterato dopo. Si combinano il boot misurato con attestazione (già visto per l'evil maid), il controllo d'integrità dei file (IMA, AIDE, database di hash degli eseguibili tenuto fuori banda) e filesystem che permettono di rilevare modifiche. Una routine periodica di verifica, eseguita da un supporto fidato e di sola lettura, trasforma il controllo in abitudine.
PoC di verifica: confrontare gli hash del sistema con una base di riferimento salvata in precedenza su supporto esterno di sola lettura:
# Creare la base (da sistema integro) e poi verificare
find /usr/bin /usr/sbin -type f -exec sha256sum {} + | sort > /mnt/usb-ro/base.sha256
sha256sum --check /mnt/usb-ro/base.sha256 | grep -v ': OK$'   # mostra solo le differenze
Costruire un sistema operativo da zero
Oltre a scegliere una distribuzione esistente si può assemblare il sistema da sé, compilando ogni componente dai sorgenti per avere il controllo completo su cosa gira sulla macchina. È un percorso istruttivo e in linea con la diffidenza verso il software che non si è verificato, ma va inquadrato: Tutanum tratta soprattutto l'integrazione di prodotti finiti e verificabili, non lo sviluppo di software ancora da realizzare. Chi vuole spingersi fino a scrivere componenti propri trova il contesto adatto nella sezione Didattica; qui si documentano i due percorsi di assemblaggio a partire da sorgenti esistenti.
Linux From Scratch (LFS)
Linux From Scratch è la costruzione passo passo di un sistema GNU/Linux compilando tutto dai sorgenti. Si parte da un sistema host, si costruisce una toolchain temporanea e isolata (compilatore, libreria C, binutils), con cui si compila poi il sistema finale e il kernel, fino alla configurazione dell'avvio. Beyond Linux From Scratch (BLFS) aggiunge il software applicativo, la rete e i servizi. Il vantaggio è il controllo totale e una superficie minima, senza pacchetti superflui; il costo è il tempo e, soprattutto, la manutenzione della sicurezza interamente manuale: senza un gestore di pacchetti occorre seguire a mano le CVE di ogni componente e ricompilare, e la riproducibilità va costruita da sé.
Un *BSD from scratch
Nei sistemi BSD il sistema base è un insieme coeso e non un collage di pacchetti indipendenti:
questo rende l'assemblaggio dai sorgenti più gestibile di LFS. Su FreeBSD si ricompilano il world e
il kernel con make buildworld e make buildkernel, scegliendo opzioni e rimuovendo
ciò che non serve; il resto del software arriva dai port o da pkgsrc. Il risultato è un
sistema su misura che conserva la coerenza e il tracciamento delle vulnerabilità della famiglia
BSD, già apprezzati nella sezione sulla documentazione, e
si sposa con la scelta di OpenBSD o FreeBSD per Tutanum.
Il confine con lo sviluppo
Costruire da zero resta un mezzo, non il fine: in genere è più sicuro partire da basi esistenti, mature e verificabili che reinventare, e poi dover mettere in sicurezza, ogni componente da capo. Lo sviluppo di software non ancora esistente esula dallo scopo di Tutanum e appartiene alla Didattica; qui interessa che qualunque codice entri nel sistema sia prima analizzato.
Una pipeline per il codice: bug, vulnerabilità e tecniche MITRE
Assemblare un sistema da zero in modo sicuro, e integrare qualunque software di terze parti, richiede una pipeline che analizzi il codice a livello sorgente prima di compilarlo e installarlo:
- Analisi statica (SAST) e linting, con mappatura delle debolezze su CWE e ragionamento sugli scenari tramite MITRE ATT&CK, per legare un difetto del codice alle tecniche d'attacco che abilita.
- Fuzzing (AFL++, libFuzzer) dei componenti che trattano input non fidato, dove si annidano i bug sfruttabili.
- Scansione continua delle dipendenze e delle vulnerabilità note (basi dati OSV e NVD), con tracciamento nel tempo.
- Build riproducibili e firma del risultato, come nella sezione Verifica e integrità del software.
È la stessa logica difensiva della pipeline del forge (Gitleaks, Semgrep, Bearer, Trivy, Grype), applicata però anche al codice di sistema e non solo alle proprie applicazioni: nessun software entra senza essere stato analizzato.
Tutanum come server di repository
Poiché il server Tutanum è pensato soprattutto per un uso domestico, può fare da server di repository e di build per tutti i dispositivi client della rete di casa. Invece che ogni macchina scarichi e compili per conto proprio da fonti esterne, moltiplicando esposizione e lavoro, è il nodo Tutanum a procurarsi i sorgenti una sola volta, verificarli, analizzarli e compilarli, servendo poi i risultati firmati ai client.
L'architettura, sviluppata nei suoi elementi:
- Fonte unica e verificata: il nodo scarica i sorgenti, ne controlla firme e checksum e li fa passare nella pipeline di sicurezza prima di compilarli, così che la provenienza di tutto il software in casa sia nota e controllata.
- Cache binaria firmata: i risultati della compilazione finiscono in una cache di binari firmati che i client installano senza ricompilare, con tecnologie come il binhost di Gentoo, le cache binarie di Nix o Guix o un archivio di pacchetti locale per le distribuzioni binarie e per i pkg BSD.
- Mirror interno: il nodo fa da mirror locale e firmato dei repository delle distribuzioni dei client, che aggiornano così da un'unica fonte interna, riducendo l'esposizione verso l'esterno e la tracciabilità dei singoli dispositivi.
- Gestione intelligente delle risorse: compilazioni pianificate nelle ore di minor carico, con limiti di CPU e memoria (cgroups su Linux, rctl su FreeBSD) e priorità adeguate (nice, ionice); dove serve, compilazione distribuita (distcc, icecc) sui soli nodi fidati e cache condivisa (sccache). Il principio è compilare una volta e distribuire a molti, non ripetere lo stesso lavoro su ogni macchina.
- Isolamento: le build girano in ambienti effimeri (container o jail), con rete limitata al solo recupero dei sorgenti, e le chiavi di firma restano fuori banda, idealmente su un dispositivo dedicato.
Il risultato resta coerente con i valori del progetto: non un servizio che scala senza limiti, ma un nodo domestico che serve i propri dispositivi, eventualmente federato con altri nodi fidati pur restando ognuno autonomo e spegnibile, in linea con l'antiscalabilità. In cambio si ottengono un solo punto di verifica e aggiornamento, meno banda consumata, minore esposizione dei client e un parco software uniforme e interamente verificato.
L'officina: analisi, compilazione e catena di fornitura
La pipeline per il codice e il server di repository descritti sopra hanno bisogno di un posto dove
girare. Metterli sul nodo significherebbe far passare sorgenti di terze parti, compilatori e scanner,
cioè la superficie d'attacco più grande, proprio sulla macchina che custodisce le chiavi e le identità.
La scelta coerente è separare i due ruoli: il nodo espone i servizi e custodisce i segreti,
un'officina distinta (una seconda macchina virtuale accanto al nodo, o un altro computer) scarica,
analizza e compila. L'officina non ha uscite proprie: tutto ciò che preleva passa dal proxy Tor del
nodo, e non può aprire connessioni verso il nodo. È il nodo a interrogarla, a intervalli, attraverso un
unico comando SSH imposto (command= in authorized_keys) che accetta solo un
elenco chiuso di richieste. Così, se un pacchetto malevolo compromette l'officina mentre la si analizza,
il danno resta lì: l'attaccante non trova chiavi e non ha una via verso il nodo.
Dall'inventario al trigger
Il punto di partenza è il package inventory: il nodo elenca ciò che ha davvero installato, sul sistema di base e in ogni jail, con l'origine di ciascun port, e lo consegna all'officina. Da lì l'officina sorveglia due fonti di cambiamento e accoda un lavoro quando qualcosa si muove: l'albero dei port propone una versione nuova di un pacchetto installato (da analizzare e compilare prima che il nodo la installi), oppure il repository a monte (ricavato dai metadati del port) pubblica un commit o un tag nuovo, materiale per la caccia ai bug prima ancora che diventi un rilascio.
La catena di scanner
Ogni albero di sorgenti attraversa la stessa pipeline difensiva già vista per il forge, qui applicata a tutto il software che entra nel sistema e non solo alle proprie applicazioni: Gitleaks per i segreti, Trivy per dipendenze, configurazioni e Dockerfile, Semgrep e Bearer per l'analisi statica del codice e dei flussi di dati sensibili, Syft per l'SBOM e Grype e osv-scanner per le vulnerabilità note delle dipendenze. Un rapporto per strumento, un riepilogo con i conteggi per gravità, e una soglia che blocca la compilazione quando emergono vulnerabilità note oltre il livello scelto. Su un'officina *BSD, coerente con la scelta del sistema operativo, alcuni di questi strumenti esistono solo per Linux: girano con lo strato di compatibilità Linux (Linuxulator), e dove nemmeno quello basta si sostituiscono con l'equivalente nativo: osv-scanner al posto di Grype per le CVE delle dipendenze. L'analisi gira come utente senza privilegi, su sorgenti mai eseguiti, e l'archivio analizzato è esattamente quello che verrà compilato.
Compilazione e repository firmato
Superata la soglia, la compilazione avviene in una jail effimera senza rete (poudriere): gli stessi sorgenti già analizzati, nessun accesso a Internet durante la build, risultati riproducibili. I pacchetti tornano al nodo, che li rifirma con la propria chiave (la chiave di firma non sta mai sull'officina) e li pubblica. La distribuzione ai client sfrutta iop: il repository è una cartella tracciata con git, e il demone iop, che ha sbloccato la propria identità cifrata all'avvio, la pubblica da solo a ogni aggiornamento verso i nodi delegati, attraverso I2P e senza un server centrale. Un pubblicatore non presidiato con chiave cifrata non potrebbe altrimenti firmare senza tenere la passphrase su disco.
Vulnerability assessment, auditing e bug bounty
La stessa officina chiude il cerchio con tre attività periodiche che non producono pacchetti ma
conoscenza. Il vulnerability assessment confronta l'inventario con il database delle
vulnerabilità note (VuXML per i port e il sistema di base), ogni pacchetto e la sua versione, e apre una
segnalazione per ogni vulnerabilità nuova. L'auditing degli errori raccoglie i fallimenti di
download, checksum e compilazione, spesso il primo segno che qualcosa a monte è cambiato o è stato
manomesso. Il bug bounty ha due facce: verso l'esterno, una scansione periodica dei propri
servizi esposti (onion, eepsite, SSH) con strumenti come nuclei, come farebbe un
attaccante; verso il basso, la caccia a bug non ancora noti nei sorgenti a monte dei pacchetti
installati (analizzatori statici per C e C++, fuzzing degli harness che gli autori già forniscono), da
segnalare agli autori in modo responsabile. Ogni risultato, da qualunque delle tre attività, diventa una
issue. Un registro a catena di hash lega tra loro i rapporti, così una manomissione successiva si
nota.
Dove finiscono le issue
Le segnalazioni non restano su una macchina che nessuno guarda: confluiscono dove si guarda già. Da un lato il nodo le aggiunge come attività a un'agenda o roadmap auto-ospitata, scrivendo nel file di sincronizzazione che quell'applicazione già usa, così appaiono tra le cose da fare sul proprio dispositivo senza che l'agenda debba esporre alcun servizio; dall'altro le più urgenti viaggiano, come ogni altro evento, nel file di stato firmato del notificatore e arrivano sul telefono. È la giunzione tra la catena di fornitura del software e il monitoraggio del nodo: una vulnerabilità scoperta a monte e un servizio che cade a valle seguono la stessa strada fino alla stessa casella di posta.
Backup
I backup sono copie di riserva di file, cartelle o interi sistemi, creati per garantire che i dati possano
essere ripristinati in caso di perdita, danneggiamento o compromissione. Fare i backup è pertanto essenziale
per prevenire la perdita permanente di dati, che può verificarsi a causa di vari fattori, come guasti
hardware, attacchi informatici, cancellazioni accidentali o errori software. Svolgono un ruolo cruciale
perché permettono di ripristinare i dati in modo sicuro e tempestivo a seguito dei problemi elencati,
causati da problematiche casuali o provocati da un potenziale attaccante o bug.
I backup si classificano in backup completi, incrementali, differenziali e mirati: quelli completi copiano
integralmente tutti i dati, quelli incrementali copiano i file che sono stati modificati rispetto all'ultimo
backup, riducendo così lo spazio di archiviazione e il tempo necessario, quelli differenziali salvano i file
modificati dall'ultimo backup completo anziché le sole modifiche, quelli mirati sono esclusivi e vanno a
mirare a singoli file o cartelle, magari con una selezione su determinati criteri.
Manualmente i backup su GNU/Linux si fanno con i software tar e rsync, mentre su *BSD si usano
i comandi dump e restore (oltre alle snapshot). Per quanto riguarda l'automatizzazione è
possibile usare Cron, Anacron per sistemi che non sono sempre accesi, OpenZFS Replication, Bacula e
Amanda.
È poi possibile cifrare i backup usando openssl, oppure gnupg.
Il tutto su GNU/Linux può essere gestito tramite borg, che è un ottimo strumento di gestione dei backup e a
livello grafico da Vorta, che utilizza sempre borg come backend.
È importante tenere ovviamente i backup separati da Tutanum e magari su una SSD cifrata e collegata
all'occorrenza, così che si aumenti anche la durata di vita del prodotto.
La regola 3-2-1 (e la sua versione paranoica)
La prassi consolidata è conservare almeno tre copie dei dati, su due supporti di natura diversa, con almeno una fuori sede. La variante più severa, detta 3-2-1-1-0, aggiunge una copia offline o immutabile e pretende zero errori in fase di verifica. L'idea di fondo è che nessun singolo evento, un guasto, un incendio, un furto, un sequestro o un attacco, debba poter distruggere tutte le copie contemporaneamente.
Cifrare sempre, prima di spostare
Un backup è una copia dei propri segreti che vive altrove, spesso in un luogo meno controllato dell'originale: è quindi un bersaglio privilegiato. Va cifrato lato client, prima di lasciare la macchina, così che il supporto o il servizio di destinazione non vedano mai dati in chiaro. Le chiavi si gestiscono con gli stessi criteri della sezione sulla crittografia: fuori banda, mai insieme al backup che proteggono. Attenzione a non perdere la chiave, altrimenti il backup è perso quanto i dati originali.
Backup e modello di minaccia
Ogni copia in più aumenta la resilienza ma anche la superficie di attacco: è un dato in più che può essere rubato o sequestrato, in tensione con il principio del need-to-know verso sé stessi visto nell'anti-forensics. La soluzione non è rinunciare ai backup, ma fare il backup solo di ciò che serve davvero, cifrarlo sempre, e considerare ogni copia come un asset da proteggere al pari dell'originale. Va inoltre ricordato che anche un backup cifrato espone dei metadati (dimensioni, date, numero e nomi degli archivi) se il sistema di backup non li protegge.
Immutabilità contro manomissione e ransomware
Un avversario che compromette il nodo tenterà di cancellare o cifrare anche i backup per impedire il ripristino. La contromisura è che le copie non siano sovrascrivibili né cancellabili da chi ha accesso al sistema: repository in sola aggiunta (append-only), snapshot bloccate (hold) o supporti WORM, e almeno una copia fisicamente scollegata (air-gapped), connessa solo durante il backup. Così l'attaccante può al più aggiungere dati, non distruggere la storia precedente.
Un backup non verificato non esiste
Il momento peggiore per scoprire che un backup è corrotto o incompleto è durante un ripristino di emergenza. Vanno quindi verificati regolarmente l'integrità degli archivi (somme di controllo) e, cosa più importante, provati i ripristini reali su una macchina di prova. Un backup di cui non si è mai testato il restore va considerato inesistente finché non lo si dimostra.
PoC di verifica: un repository borg cifrato e in sola aggiunta, con controllo d'integrità e prova di ripristino:
# Inizializzare un repository cifrato (chiave + passphrase)
borg init --encryption=repokey-blake2 /mnt/backup/repo

# Creare un archivio (deduplicato e cifrato)
borg create --stats /mnt/backup/repo::$(hostname)-$(date +%F) /dati

# Lato server del repository: consentire solo l'aggiunta, non la cancellazione
#   in ~/.ssh/authorized_keys: command="borg serve --append-only ..."

# Verificare l'integrità e provare un ripristino di controllo
borg check --verify-data /mnt/backup/repo
borg extract --dry-run /mnt/backup/repo::archivio-da-testare
Namespace, container e jail
I namespace sono istanze isolate istanzializzate dal kernel per mezzo di chiamate (syscall).
Sono una caratteristica fondamentale del kernel Linux e permette l'isolamento di risorse tra i
processi.
Sono utilizzati per costruire ambienti separati simili a container (retorica usata anche in Docker, un
software per la gestione dei namespace).
Presso questi container i gruppi di processi possono vedere ed interagire solo con un insieme ristretto di
risorse del sistema, come l'albero dei processi, la rete, il filesystem e molto altro.
I namespace sono pertanto una delle tecnologie alla base dei container come Docker, Podman, LXC e Kubernetes
(che usa Docker).
La documentazione online è scadente e vecchia (2008/2009), ed è stata pure "ostacolata da Linus Torvalds.
Implementare in maniera decente i container richiede oltretutto un'ottima conoscenza del linguaggio C (ad
esempio l'implementazione delle SECCOMP, Secure Computing Mode, per quanto riguarda le limitazioni di alcune
syscall che un processo può eseguire), cosa
che potrebbe essere risolta con qualche tool o framework da usare per poterli implementare in maniera
modulare e più semplice.
Qui di seguito la guida dei namespace, una raccolta di informazioni lungo gli studi condotti sia online che
offline:
Ci sono diversi tipi di namespace, ognuno dei quali isola una specifica risorsa o aspetto del sistema:
- User Namespace (CLONE_NEWUSER): Isola l'identità dell'utente. All'interno di uno user namespace, l'utente può essere mappato all'UID 0 (root), senza avere i privilegi del vero utente root nel sistema host. Permette pertanto agli utenti non root di ottenere privilegi elevati all'interno del namespace, senza comprometterli a livello globale (quindi senza andare ad intaccare il filesystem uno può diventare root senza inserire la password).
- PID Namepsace (CLONE_NEWPID): Isola l'albero dei processi. I processi nel nuovo namespace PID vedono un insieme separato di PID, con il processo iniziale all'interno del namespace che ha PID 1, similmente a quanto accade nel sistema host con il processo init.
- Mount Namespace (CLONE_NEWNS): Isola i punti di montaggio. All'interno di un mount namespace, i processi possono avere una visuale diversa del filesystem, permettendo di montare e smontare file system senza influenzare il sistema host o altri namespace.
- Network Namepsace (CLONE_NEWNET): Isola le risorse di rete. Questo include le interfacce di rete, gli indirizzi IP, le regole del firewall, le tabelle di routing, ecc. Ogni network namespace ha le proprie interfacce di rete virtuali e stack TCP/IP separati.
- UTS Namespace (CLONE_NEWUTS): Isola il nome host e il nome del dominio. All'interno di un UTS namespace, i processi possono avere il proprio hostname e domainname separati, indipendenti da quelli del sistema host.
- IPC Namespace (CLONE_NEWIPC): Isola la memoria condivisa (SysV IPC), le code di messaggi e i semafori. Consente ai processi di utilizzare risorse IPC isolate.
- Cgroup Namespace (CLONE_NEWCGROUP): Isola la visione delle gerarchie dei cgroup, consentendo ai processi di vedere solo la propria posizione nella gerarchia dei cgroup senza influenzare i processi al di fuori del namespace.
Ogni processo appartiene a uno specifico set di namespace. Quando un nuovo namespace viene creato, i processi
al suo interno vedono una versione isolata della risorsa corrispondente (utente, rete, PID, ecc.), che è
indipendente da quella visibile al sistema host o agli altri namespace.
Possono essere creati usando le chiamate di sistema al kernel unshare(), clone(), o eseguendo comandi
come unshare o nsenter da riga di comando.
Un namespace sarà presente finché ci saranno processi che vi appartengono; quando l'ultimo processo nel
namespace terminerà, il namespace stesso verrà distrutto.
In particolare le chiamate di sistema possono essere documentate come segue:
- unshare(): Permette ad un processo di lasciare il namespace corrente e unirsi a uno nuovo per una specifica risorsa. La sintassi è int unshare(int flags), come ad esempio unshare(CLONE_NEWNET) che crea una nuova rete namespace per il processo chiamante.
- clone(): Crea un nuovo processo che può essere isolato in uno o più namespace. La sintessi è int clone(int (*fn)(void *), void *stack, int flags, void *arg...); e può essere utilizzato con i flag dei namespace (es. CLONE_NEWPID) per creare un nuovo processo isolato.
- setns(): Permette ad un processo di unirsi ad un namespace esistente. La sintassi è int setns(int fs, int nstype);. fd è un file descriptor che rappresenta il namespace, ottenuto tipicamente da /proc/[proc]/ns/.
A livello di comandi invece la documentazione è quella che segue:
-
unshare: Permette di eseguire un comando all'interno di uno o più nuovi namespace. La sintassi è
unshare [opzioni] [comando], dove
--user va a creare un nuovo user namespace,
--pid va a creare un nuovo PID namespace,
--net va a creare una nuova rete namespace,
--mount va a creare un nuovo mount namespace,
--fork va ad eseguire il comando in un nuovo processo,
--map-root-user va a mappare l'utente corrente come root nel namespace.
Ad esempio unshare --user --map-root-user --pid --fork --mount-proc /bin/bash esegue una nuova shell bash con isolamento utente (dove l'utente diventa root nel namespace), PID e filesystem. -
Il comando nsenter permette di eseguire un comando all'interno di un namespace esistente,
specificato tramite un file descriptor, come quelli disponibili in /proc/[pid]/ns/.
La sintassi è nsenter [opzioni] --target [pid] [comando] dove le opzioni sono:
--net entra nel network namespace del processo target,
--uts entra nel UTS (UNIX Timesharing System) namespace del processo target
--pid entra nel PID namespace del processo target,
--mount entra nel mount namepsace del processo target.
Un esempio di utilizzo del comando è nsenter --target 1234 --net /bin/bash, ciò che fa è avviare una shell bash nel network namespace del processo con PID 1234.
Alcuni comandi utili per la gestione dei namespace sono i seguenti:
-
Creazione di un nuovo User e PID Namespace:
unshare --user --map-root-user --pid --fork /bin/bash
Questo comando apre una nuova shell bash dove l'utente corrente è root solo all'interno del namespace. Inoltre, i PID sono isolati. -
Creazione di un Network Namespace:
unshare --net --pid --fork /bin/bash
Questo comando crea un nuovo network namespace, isolando le risorse di rete (come le interfacce di rete e gli indirizzi IP) dalla shell corrente. -
Creazione di un Mount Namespace e Montaggio di /tmp come isolato:
unshare --mount /bin/bash && mount --bind /tmp /tmp
Questo comando crea un nuovo mount namespace e rimappa /tmp per essere isolato solo all'interno del namespace.
Come avete potuto notare i container sono molto difficili da pilotare e soprattutto orchestrare, il che li rende inadatti in tema di sicurezza, o comunque difficilmente gestibili.
Le jail, una tecnologia simile ma al contempo implementata differentemente, è tutta un'altra faccenda. Le
jail sono implementate e supportate in FreeBSD e riguardano una tecnologia di virtualizzazione leggera,
usata per isolare applicazioni o ambienti utente, offrendo un alto grado di separazione e controllo delle
risorse del sistema operativo. Sono molto simili ai container di Linux, ma le jail sono state inventate nel
2000 e fanno parte del sistema operativo FreeBSD da allora.
Una jail è pertanto un ambiente isolato creato sopra FreeBSD e può contenere il proprio filesystem, utenti,
network stack e servizi, ma condivide lo stesso kernel con l'host. Questo approccio fornisce un alto livello
di isolamento e sicurezza per le applicazioni, senza l'overhead di eseguire kernel separati come avviene in
un hypervisor tradizionale (si faccia riferimento al funzionamento delle macchine virtuali).
Ogni jail può essere considerata come un piccolo "sottosistema" che può eseguire i suoi demoni, server e
applicazioni, senza interferire con l'host o con le altre jail sul sistema.
Ci sono due modalità principali di jail: le Traditional Jail, il tipo classico, dove la jail ha il
proprio filesystem, può avere utenti indipendenti e può eseguire le applicazioni isolate, e la VNET
Jail, che include un proprio stack di rete completamente isolato, avendo pertanto la propria tabella
di routing, interfacce di rete e può essere configurata con il protocollo IPv4 e IPv6 (sconsigliato per via
del leak sul MAC Address).
Per creare una jail è innanzitutto necessario installare il pacchetto ezjail, installabile col
comando doas pkg install ezjail.
Dopodiché è possibile creare una jail col comando doas ezjail-admin install, il cui comando andrà a
creare una base jail che verrà utilizzata per le altre jail.
Per creare una jail utilizzabile è possibile crearla secondo questo esempio:
doas ezjail-admin create myjail 'lo1|192.168.1.10'
avviabile col comando
doas ezjail-admin start myjail
Oppure è possibile configurare il file /etc/jail.conf e utilizzando alcuni comandi nativi di FreeBSD,
per ottenere una jail "statica" e quindi che non richiede l'avvio manuale:
myjail {
path = /usr/jails/myjail;
host.hostname = "myjail.local";
ip4.addr = 192.168.1.10;
mount.devfs;
exec.start = "/bin/sh /etc/rc";
exec.stop = "/bin/sh /etc/rc.shutdown";
}
avviabile col comando
doas service jail start myjail
Per potervi accedere si può usare il comando
doas jexec myjail /bin/csh
E per eliminarla il comando
doas ezjail-admin delete -w myjail
Ogni jail può essere configurata per avere uno o più indirizzi IP assegnati, sia su interfacce reali che
virtuali (come lo1). Ad esempio può avere il proprio IP univoco, configurabile in jail.conf o con ezjail,
oppure può avere il proprio stack di rete e quindi una VNET, nonché inclusa una propria tabella di routing,
azione utile per applicazioni di rete complesse o per isolare completamente il traffico di rete della
jail.
Esempio di jail.conf:
myjail {
    vnet;
    vnet.interface = "epair0b";
    exec.prestart = "ifconfig epair0 create up";
    exec.prestart += "ifconfig epair0b vnet myjail";
}
È possibile configurarle anche con delle impostazioni di sicurezza chiamate "restrictions" e "devfs
rulesets".
Con le restrictions è possibile restringere i permessi di una jail per limitarne l'accesso a risorse di
sistema tramite il parametro allow in jail.conf, ad esempio:
allow.mount;
allow.raw_sockets;
Con devfs rulesets invece si possono limitare i dispositivi che sono visibili all'interno della jail, come
ad esempio:
mount.devfs;
devfs_ruleset = 4;
È pure importante sapere che è possibile fare snapshot delle jail, mentre dei container no, o almeno non
nativamente.
È possibile con pochi comandi ad esempio, creare una jail con all'interno un web server come nginx:
doas ezjail-admin create webserver 'lo|192.168.1.20'
doas jexec webserver pkg install nginx
doas jexec webserver service nginx start
La cui rete VNET può essere configurata come segue:
myvnetjail {
    vnet;
    vnet.interface = "epair0b";
    exec.prestart = "ifconfig epair0 create up";
    exec.prestart += "ifconfig epair0b vnet myvnetjail";
}
Se le jail sono troppo macchinose, è stato creato un framework per la loro gestione e orchestrazione, in
ambienti virtuali su FreeBSD, DragonFlyBSD e Linux: CBSD (CoreBSD).
L'obiettivo di tale software è semplificare la creazione, la gestione e il mantenimento di jail, bhyve
(l'hypervisor di FreeBSD), Xen e altri ambienti di virtualizzazione, utilizzando un approccio simile a
quello dei container (Docker).
Le funzioni principali sono:
- Creare, avviare e fermare jail e macchine virtuali.
- Monitorare l'utilizzo delle risorse.
- Gestire lo storage delle jail e delle VM.
- Configurare networking per ambienti isolati.
- Creare immagini predefinite e riutilizzabili.
CBSD offre un'interfaccia a linea di comando (CLI) unificata e consente di gestire sia jail che macchine
virtuali con strumenti integrati.
Può essere installato facilmente col comando doas pkg install cbsd o tramite i port, usando il
comando cd /usr/ports/sysutils/cbsd && doas make install clean.
Una volta installato CBSD è necessario inizializzarlo col comando doas cbsd initenv.
Il comando prepara l'ambiente CBSD creando la directory di lavoro /usr/jails o una personalizzata se
specificata, e configurando i permessi necessari. Oltre a quella crea anche il file
/usr/local/cbsd/cbsd.conf, file contenente le impostazioni che riguardano il comportamento predefinito delle
jail e delle VM, come percorsi di storage, impostazioni di rete e risorse di sistema.
È possibile per esempio configurare i parametri
workdir, che è il percorso di lavoro principale dove CBSD gestisce le jail e le VM,
jail_default_interface, che è l'interfaccia predefinita che sarà utilizzata dalle jail,
bhyve_enable, che abilita o disabilita la gestione di macchine virtuali bhyve,
zfs_enableche abilita o disabilita il supporto a ZFS per la gestione dello storage delle jail o delle
VM.
Per verificare la corretta configurazione è poi utile utilizzare il comando cbsd jls.
Se non ci sono jail create, non verranno visualizzate, ma il comando dovrebbe restituire correttamente la
struttura.
Per costruire una jail in maniera semplice con CBSD si possono seguire i seguenti passaggi:
Eseguire il comando doas cbsd jconstruct-tui seguito dal nome della jail, quindi doas cbsd
jconstruct-tui myjail, il quale avvierà un'interfaccia testuale interattiva per configurare la
jail.
Oppure è possibile direttamente crearla inline col comando doas cbsd jconstruct name=myjail
ver=13.2.
È possibile poi avviarla col comando doas cbsd jstart myjail, fermarla col comando cbsd jstop
myjail, eliminarla col comando doas sudo cbsd jremove myjail e ottenere informazioni col
comando cbsd jls.
Per la virtualizzazione con bhyve è possibile usare CBSD eseguendo il comando:
doas cbsd bconstruct-tui
Avviabile con cbsd bstart vmname, fermabile con doas cbsd bstop vmname, ed eliminabile con
doas cbsd bremove vmname.
CBSD supporta configurazioni di rete sia semplici che complesse. È possibile assegnare indirizzi IP statici
o utilizzare il bridge per connettere jail e VM alla rete esterna.
Nella configurazione di una jail, è possibile specificare l'interfaccia di rete e gli indirizzi IP. Ad
esempio:
doas cbsd jconstruct name=myjail ver=13.2 ip4_addr="192.168.1.10"
Per le VM, è possibile configurare un'interfaccia bridge che connette la VM alla rete esterna o utilizzare
una rete interna, ad esempio:
doas ifconfig bridge0 create
doas ifconfig bridge0 addm em0 up
Oltre agli snapshot è possibile anche effettuare dei veri e propri backup, col comando doas cbsd jexport
myjail, il quale andrà a generare una tarball contenente tutti i dati della jail. Il ripristino
avviene col comando doas cbsd jimport /path/to/myjail.tar
Parallelamente al sistema dei container e delle jail, il progetto Whonix integra un sistema a compartizione stagna dove ogni processo o istanza è vincolata in una macchina virtuale all'interno del sistema Qubes, che usa come hypervisor, ovvero come gestore di macchine virtuali, il software Xen, derivato dallo Xen Project.
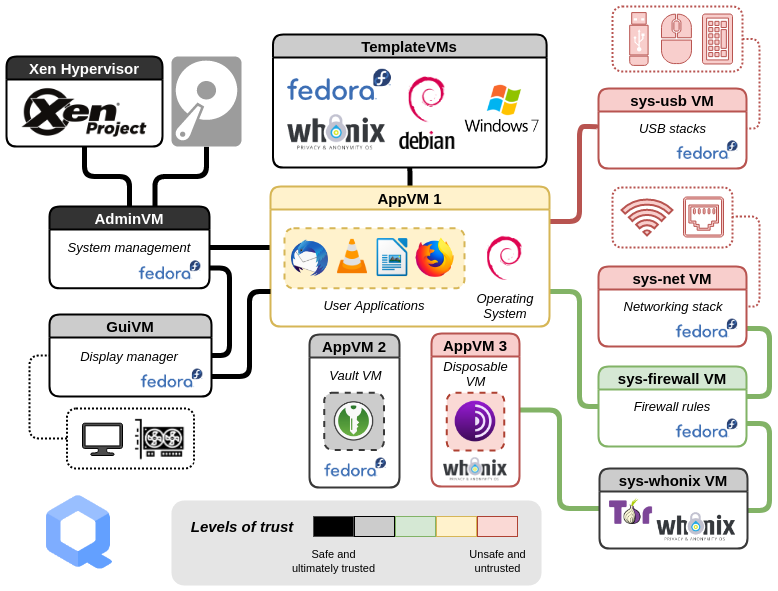
Qui sopra nell'immagine abbiamo un esempio dell'architettura di Qubes, dove ogni sezione presenta un livello
di fiducia, modificabili dal Qube Manager.
I suoi punti a sfavore riguardano più che altro l'utilizzo di parecchie risorse: sono consigliati almeno 6GB
di RAM e 32GB di spazio libero minimi, ma per una buona e corretta esecuzione consigliano 16GB di RAM e
128GB di spazio libero. Isolare le intere applicazioni può essere una buona soluzione, soprattutto per
quanto riguarda i permessi e questa cosa potrebbe essere implementata benissimo anche alle jail.
Il problema delle jail e di conseguenza di cbsd tuttavia, è che, almeno su architettura arm,
attualmente
risulta impossibile
virtualizzare con bhyve sistemi operativi come Gentoo, il che rende Tutanum Classico adatto più che
altro
per CPU con architetture supportate come x86 e amd64, mentre per le altre architetture rimane
necessario
implementare Tutanum Lieve.
Quando un'applicazione non entra in una jail
Non tutto il software sta in una jail. Un'applicazione distribuita come insieme di container Linux
— più servizi che cooperano, un fornitore di identità, uno o più database, un
proxy — ha bisogno di un kernel Linux e di un motore di container (Docker, podman):
né una jail FreeBSD né lo strato di compatibilità Linux la reggono. Davanti a un
software simile ci sono tre strade, da pesare su tre assi: isolamento, risorse, manutenzione.
La macchina virtuale dedicata è di norma la scelta onesta. L'isolamento è il più forte (kernel separato); un container Linux condividerebbe il kernel dell'host che fa girare anche il nodo coi segreti, e una sua evasione arriverebbe fino a lì — il compromesso sbagliato proprio dove si trattano dati sensibili. E l'applicazione gira identica a monte, senza un fork da mantenere per sempre, che è il prezzo dell'alternativa: ri-scrivere i suoi servizi in forma nativa (il backend e i database in jail, il frontend compilato in pagine statiche, il fornitore di identità sostituito da uno più leggero). La riscrittura entra nel modello e costa poca memoria, ma è lavoro continuo a ogni versione a monte; vale la pena solo se l'applicazione deve vivere dentro il perimetro sigillato a lungo.
Qualunque strada, la disciplina non cambia: l'ospite non ha uscite proprie (esce solo dal proxy Tor del nodo), è raggiungibile soltanto come servizio nascosto (eepsite I2P o onion), e si aggiorna tirando dal proprio repository, mai ricevendo una spinta — esattamente come l'officina. Resta un costo che non si aggira: la memoria. Un fornitore di identità e due database non stanno in poche centinaia di MiB; o cresce l'hardware, o l'applicazione va ridisegnata. È una decisione da prendere prima, non dopo aver scelto il software.
Proxmox VE
Jail e container isolano i processi ma condividono il kernel dell'host. Quando serve un altro kernel, o un altro sistema operativo, ci vuole una macchina virtuale. Sui sistemi BSD la strada è bhyve, già visto con CBSD. Nel mondo GNU/Linux lo strumento più diffuso per tenere insieme macchine virtuali e container è Proxmox VE, e conviene capire che cosa offre e quanto costa, perché per una parte dell'hardware di recupero è un'opzione seria.
Che cos'è
Proxmox VE è una distribuzione basata su Debian che riunisce sotto un'unica gestione due tecnologie:
le macchine virtuali KVM/QEMU, ciascuna con il proprio kernel, e i container LXC, che usano i
namespace e i cgroup descritti sopra e condividono il kernel dell'host. Si amministra da
un'interfaccia web, dalla riga di comando (qm per le macchine virtuali,
pct per i container) o da un'API. Integra ZFS, istantanee, backup, un firewall per ogni
ospite e, per chi ha più macchine, cluster e migrazione a caldo. È software libero, con licenza
AGPLv3, sviluppato da un'azienda austriaca che vende abbonamenti di supporto.
La flessibilità che offre
| Jail o container | Macchina virtuale | Proxmox | |
|---|---|---|---|
| Kernel | Quello dell'host | Proprio | Entrambi, scelti caso per caso |
| Sistemi ospitabili | Solo lo stesso dell'host | Qualsiasi | FreeBSD, OpenBSD, GNU/Linux e altro sulla stessa macchina |
| Isolamento | Una vulnerabilità del kernel vale per tutti | Per uscire serve una falla dell'hypervisor | Forte per le macchine virtuali, debole per i container |
| Risorse | Minime | RAM e disco riservati a ogni ospite | Si paga solo dove serve l'isolamento forte |
| Hardware visto dall'ospite | Quello reale | Virtuale e uniforme | Lo stesso ospite gira identico su macchine diverse |
Da questa combinazione vengono i vantaggi pratici.
- Un sistema operativo diverso da quello che l'hardware gradisce: il kernel Linux riconosce molto più hardware vecchio o insolito di quanto facciano i sistemi BSD. Proxmox può fare da strato di adattamento: sotto c'è Linux che parla con il ferro, sopra una macchina virtuale FreeBSD che vede soltanto dispositivi virtuali standard e ospita il nodo Tutanum con le sue jail.
- Istantanee dell'intera macchina: prima di un aggiornamento si fotografa tutto, kernel compreso, e si torna indietro in pochi secondi.
- Modelli e cloni: un nodo configurato una volta diventa un modello da cui ricavarne altri, per provare una modifica senza toccare l'originale.
- Ospiti portabili: il backup di una macchina virtuale si ripristina su un altro computer, anche molto diverso, senza reinstallare.
- Compartimenti alla maniera di Whonix: un ospite fa da gateway verso Tor e gli altri escono soltanto attraverso di lui, su una rete interna senza alcuna porta fisica. Whonix stesso è distribuito per KVM.
- Software che esiste solo per Linux: gira in una macchina virtuale propria, senza contaminare il nodo.
I limiti
- È molto codice: Debian, systemd, un kernel derivato da quello di Ubuntu, QEMU, LXC, un'interfaccia web scritta in Perl, un filesystem di cluster, demoni di statistica e di alta disponibilità. Tutto gira come root. Ogni componente è superficie d'attacco che un nodo fatto di FreeBSD e jail non ha.
- L'interfaccia web è una porta di amministrazione: ascolta sulla porta 8006 su tutte le interfacce. Chi la viola controlla ogni ospite.
- I container LXC restano container: condividono il kernel dell'host. Vanno usati solo non privilegiati, e mai per ciò che è esposto.
- Dall'hypervisor si esce: QEMU ha avuto falle che permettevano a un ospite di eseguire codice sull'host (VENOM, CVE-2015-3456, è la più nota). E i canali laterali del processore attraversano il confine tra macchine virtuali: sulle CPU datate va spento l'hyper-threading e disattivata la deduplicazione della memoria (KSM).
- Chiede risorse: ZFS e ogni ospite vogliono la propria RAM. Sotto gli 8 GB non è una strada praticabile.
- Niente cifratura del disco nell'installazione guidata: per averla bisogna installare prima Debian su un volume cifrato e aggiungere Proxmox sopra, oppure cifrare a mano i dataset ZFS.
- Solo x86: il supporto ufficiale riguarda i processori a 64 bit di Intel e AMD con le estensioni di virtualizzazione. Per le schede ARM del Classico non c'è.
- Non risolve ciò che sta sotto: Intel ME e il firmware proprietario restano al loro posto, un gradino più in basso dell'hypervisor.
Proxmox e i valori del progetto
| Valore | Proxmox | Giudizio |
|---|---|---|
| Software libero | Licenza AGPLv3, codice pubblico. Installa però firmware e microcodice non liberi | Rispettato, con riserva |
| Semplicità (KISS) e software suckless | Una piattaforma integrata che nessuno legge per intero, costruita su systemd e D-Bus | Non rispettato |
| Antiscalabilità | Nasce per i datacenter: cluster, alta disponibilità, storage distribuito. Un nodo singolo si porta dietro strumenti pensati per la delega | Non rispettato |
| Assenza di scopo di lucro | Il repository consigliato per la produzione è riservato a chi paga l'abbonamento; quello gratuito è dichiarato meno collaudato, e l'interfaccia lo ricorda a ogni accesso | Non rispettato |
| Decentralizzazione | La direzione del progetto dipende da una sola azienda | Rispettato in parte |
| Accessibilità e riuso | Fa funzionare hardware di recupero che i sistemi BSD non riconoscono, e rende gli ospiti indipendenti dal ferro | Rispettato |
| Privacy | Non risulta inviare telemetria: i contatti verso l'esterno sono i repository e la verifica dell'abbonamento | Rispettato |
| Scelte di sistema | systemd, glibc, amministrazione da root: l'opposto di quanto raccomandato in Init system, GLIBC e Privilegi amministrativi | Non rispettato |
Il bilancio è chiaro: Proxmox è software libero e utile, ma è l'opposto di un sistema che una sola persona può leggere e tenere in mano. Chi lo adotta lo fa sapendo di scambiare semplicità con flessibilità.
Quando usarlo
Per Tutanum Classico la risposta è no. L'hardware è scelto apposta perché FreeBSD vi giri direttamente, e jail e bhyve danno container e macchine virtuali restando dentro i valori del progetto. Aggiungere Proxmox significherebbe mettere sotto il nodo lo strato più complesso di tutta l'infrastruttura.
Per Tutanum Lieve la risposta può essere sì, e per tre ragioni che vengono dalla natura stessa del Lieve.
- L'hardware non l'ha scelto nessuno: se FreeBSD non riconosce la scheda di rete o il controller del disco di un vecchio computer, Proxmox lo rende comunque utilizzabile, e il nodo Tutanum gira identico in una macchina virtuale.
- La fiducia era già limitata: un Lieve non custodisce i segreti più importanti. Uno strato complesso in più pesa meno dove il fondo non è comunque verificabile.
- I ruoli del Lieve ne traggono vantaggio: banco di prova, esca e nodo ridondato sono proprio i casi in cui istantanee, cloni e ripristino rapido servono di più.
Anche sul Lieve resta una scelta da fare solo se serve. Se FreeBSD riconosce l'hardware e il nodo deve fare una cosa sola, l'installazione diretta resta migliore. E ci sono casi in cui Proxmox va escluso: meno di 8 GB di RAM, processore senza estensioni di virtualizzazione, impossibilità di tenere l'interfaccia di amministrazione fuori dalla rete.
Ridurne i danni
Chi lo usa lo riporta, per quanto possibile, verso i valori del progetto.
- Disco cifrato: Debian installato su un volume cifrato, e Proxmox aggiunto sopra seguendo la documentazione ufficiale.
- Nodo singolo, niente cluster: i servizi di cluster e di alta disponibilità si spengono. È l'antiscalabilità applicata a uno strumento che non la prevede.
- Interfaccia web solo in locale: la si fa ascoltare su
127.0.0.1e la si raggiunge con un tunnel SSH, con il secondo fattore attivo. - Firewall in default-deny a livello di host e di ogni ospite.
- Solo macchine virtuali per ciò che conta: i container LXC, sempre non privilegiati, solo per servizi interni e sacrificabili.
- Canali laterali: hyper-threading e KSM spenti.
- Rete interna senza porta fisica: gli ospiti secondari escono soltanto attraverso la macchina virtuale del nodo Tutanum, quindi attraverso Tor o I2P.
- Aggiornamenti attraverso Tor, dal repository gratuito.
I comandi sono nella guida Tutanum Lieve.